Agent Loop 核心流转与生命周期控制 (packages/agent)
 Jayden
自己动手构建 Agent · 第 1 章 · 上一章:模型流式接入与兼容层设计
上一章我们把 packages/ai 这一层收敛干净了:不管底层对接 OpenAI 还是 Anthropic,上层业务拿到的都是标准化的流式事件、结构化的工具参数以及经过协议校验的纯净输出。
搞定了单次模型调用,下一步自然就是把多次调用串起来,让 Agent 能够自己跑完一个多步骤任务,也就是社区常说的 Agent Loop(代理主循环)。
很多人在最初写 Agent 时,觉得主循环就是一个简单的 while (true):
- 把当前的 Prompt 和历史消息丢给模型;
- 模型返回纯文本就打印并退出,返回工具调用就去执行对应函数;
- 把工具执行结果追加到消息列表,进入下一轮
while。
while (true) {
  const msg = await model.invoke(messages, tools);
  messages.push(msg); // 1. 记下模型的回复(里面包含它要调什么工具)

  if (!msg.toolCalls?.length) return messages; // 2. 没有 toolCalls 时退出

  for (const m of msg.toolCalls) {
    const result = await tools.execute(m.name, m.args); // 3. 按工具名执行
    messages.push({ role: "tool", toolCallId: m.id, content: result }); // 4. 关联 toolCallId 追加结果
  }
}
这个逻辑在跑简单的 Demo 时完全够用,几十行代码就能跑通。但要把代码放进真实的 Coding Agent 跑复杂长任务,这个 while 循环会立刻暴露出四个工程问题:
- 过程黑盒与上下文原地污染:上面这段函数跑起来之后是个黑盒,只有等所有轮次全部跑完才会
return messages,外部 UI 根本不知道当前正在调第几个工具;而且代码直接在传入的messages数组上原地push,调用方原本持有的历史上下文直接被改乱了。 - 工具调度与报错容错:模型经常在一次回复里同时发出多个工具调用。只读工具适合并发执行以缩短耗时,带副作用的写操作则必须串行阻塞;而且一旦模型传错了参数或者工具执行报错,
await tools.execute直接抛异常就会把整个while循环炸断。 - 运行中途的用户插话与退出控制:Agent 跑长任务经常要花几分钟,这期间用户随时会发新消息纠正方向,或者按
ESC取消,单次任务也可能陷入死循环需要轮次上限保护。 - 外部副作用的权限拦截:读文件没有破坏性,但删除文件、修改代码、执行 Shell 命令会产生外部副作用。主循环在真正调用工具函数前,必须留出统一的拦截点来做权限审批。
这篇笔记主要复盘 packages/agent/src/core/agent-loop.ts 的设计与实现。我们直接从上面那 15 行 while (true) 出发,一步步把它改造成生产级的 Agent Loop。
生命周期事件与上下文隔离
我们先拿一个具体的任务来跑一遍上面的 while (true)。假设我们给刚跑起来的 Agent 派第一件活:
“去读一下
loop.ts和刚报错的crash.log,看看你刚才为什么陷入死循环了,顺便把那个 bug 修掉。”
理想情况下,Agent 会分三轮(Turn)完成这件工作:
- 第 1 轮(Turn 1):模型同时发出两个
Read工具调用,分别读取loop.ts和crash.log; - 第 2 轮(Turn 2):模型看完代码和日志,定位到死循环原因,发出一个
Edit工具调用修改loop.ts; - 第 3 轮(Turn 3):文件修改成功,模型不再调用工具,输出最终回复:“我已经把自己修好了。”
如果用开头的 while (true) 来跑这个任务,前端界面会在长达十几秒的时间里毫无反应,直到第 3 轮结束才一次性弹出所有消息。
三层生命周期事件 (CoreAgentEvent)
为了让外部实时感知进度,我们不能等循环结束才返回结果,必须让主循环边跑边往外吐事件。那么外部调用方到底关心哪些边界?
- UI 界面需要知道:什么时候开始生成一条新消息(好渲染一个空白气泡)、文字流式吐到了哪里、哪个工具开始转圈执行了、哪个工具执行完了。
- 日志与状态管理层需要知道:哪几条消息属于同一个推理轮次(Turn),整个任务(Run)什么时候彻底结束并拿回本次新增的所有消息。
顺着这个诉求,packages/agent/src/core/types.ts 将一次运行的生命周期拆成了由外到内的三层事件(CoreAgentEvent):
- Run 级(
agent_start/agent_end):对应一次完整的agentLoop()调用,包含多个 Turn。 - Turn 级(
turn_start/turn_end):对应“一次模型推理 + 该次推理触发的所有工具执行”。 - Message 与 Tool 级:Turn 内部每条消息的开始、流式更新、结束(
message_start/message_update/message_end),以及每个工具的执行进度(tool_execution_start/tool_execution_update/tool_execution_end)。
把这个事件设计套回刚才“Agent 修自己 bug”的任务里,主循环向外广播的事件流就非常清晰了:
agent_start                                  // 1. Run 启动
 ├─ turn_start                               // 2. Turn 1 开始
 │   ├─ message_start / message_end          //    注入用户 Prompt
 │   ├─ message_start                        //    模型开始流式回复
 │   ├─ message_update (toolcall_delta...)   //    流式拼装两个 Read 调用 (loop.ts, crash.log)
 │   ├─ message_end                          //    模型回复完成 (stopReason: "toolUse")
 │   ├─ tool_execution_start (Read x2)       //    两个只读工具并行启动
 │   ├─ tool_execution_end   (Read x2)       //    读取完毕
 │   ├─ message_start / message_end (x2)     //    两条 ToolResultMessage 落盘
 │   └─ turn_end                             //    Turn 1 结束 (hasMoreToolCalls: true)
 │
 ├─ turn_start                               // 3. Turn 2 开始
 │   ├─ message_start / message_update / message_end // 模型决定调用 Edit 修代码
 │   ├─ tool_execution_start (Edit)          //    通过权限审批后执行写操作
 │   ├─ tool_execution_end   (Edit)          //    修改完成
 │   ├─ message_start / message_end          //    ToolResultMessage 落盘
 │   └─ turn_end                             //    Turn 2 结束 (hasMoreToolCalls: true)
 │
 ├─ turn_start                               // 4. Turn 3 开始
 │   ├─ message_start / message_update / message_end // 模型输出“我已经把自己修好了” (stopReason: "stop")
 │   └─ turn_end                             //    Turn 3 结束 (hasMoreToolCalls: false)
 └─ agent_end (messages: [...newMessages])   // 5. Run 结束,返回本次新增的全部消息
入口契约与上下文隔离 (AgentLoopRuntime)
在上一章中,packages/ai 提供了双模消费的 EventStream:既可以用 for await 实时消费事件,也可以用 await stream.result() 直接等待最终结果。agentLoop 在入口处直接复用了这套机制:
export function agentLoop(prompts: AgentMessage[], context: AgentContext, config: AgentLoopConfig, ...): AgentEventStream {
  const stream = new EventStream<CoreAgentEvent, AgentMessage[]>(
    (event) => event.type === "agent_end",
    (event) => (event.type === "agent_end" ? event.messages : []),
  );
  const runtime: AgentLoopRuntime = {
    context: { ...context, messages: [...context.messages], tools: [...context.tools] },
    newMessages: [],
    // ...
  };

  void driveAgentLoop(prompts, runtime).catch((error) => { ... });
  return stream;
}
对比最开始的 while (true),你可能会问:我本来就是要把新消息追加到对话历史里,为什么不直接修改传进来的 context.messages,反而要做浅拷贝隔离、还要分成 context.messages、newMessages 和 prepareContext 三处状态?
如果直接像开头的 while (true) 那样在原数组上原地 push,在真实场景里会踩中三个具体的坑:
- 中途取消或重试时,外部历史被“半成品”污染(所以入口要做浅拷贝): 假设用户当前已经有 10 条干净的对话历史
session.messages,现在发起第 11 轮提问。Agent 在内部跑了两轮工具,往数组里push了 4 条中间消息,这时候网络断了,或者用户觉得方向不对按了ESC取消,想点击“重试”重新提问。如果agentLoop直接修改了外部传入的原数组,那 4 条跑了一半的残缺消息(比如只有toolCall还没来得及生成toolResult)就已经混进session.messages里了,下次重试发给模型会立刻触发 400 协议报错。因此入口处用[...context.messages]拷走一份内部工作副本,哪怕中途崩了,外部宿主手里的原数组依然停留在干净的第 10 条。 - 调用方需要精准知道“这次运行到底新增了什么”(所以要单独维护
newMessages): 当一次agentLoop跑完退出时,传入的context.messages里混杂着几百条历史旧消息和本轮刚产生的几条新消息。数据库持久化层或子 Agent 调用方往往只需要拿到“本次运行新产生的消息列表”去落盘或汇总,因此单独用newMessages收集本次增量,在agent_end时通过stream.result()一并返回。 - 单次请求的临时裁剪不能永久删改真实历史(所以每轮
prepareContext要再拷一次): 在每一轮真正发起 HTTP 请求前,业务层经常需要做一些“只针对当前这一次请求”的临时加工。比如:当前进入了只读的“规划模式(Plan Mode)”,需要在这一轮临时把Edit和Bash从tools列表里删掉;或者历史消息太长了,需要把前 30 条旧消息临时替换成 1 条压缩摘要发给模型。如果直接把runtime.context的引用传给prepareContext回调,这些临时裁剪就会把主循环里的完整对话历史和工具列表永久覆盖掉(等下一轮退出规划模式时,Edit工具再也找不回来了)。所以每次请求模型前,都会再拷一份临时副本传给prepareContext:
// 给 prepareContext 传副本,单次请求的临时裁剪改不动 run 内部的真实历史
const input: AgentContext = {
  systemPrompt: context.systemPrompt,
  messages: [...context.messages],
  tools: [...context.tools],
};
const prepared = config.prepareContext ? await config.prepareContext(input) : input;
工具调度、错误处理与中间件
在刚才的例子里,Turn 1 模型同时发出了两个 Read 调用,Turn 2 发出了一个 Edit 调用。如果还像开头的 while (true) 那样写个简单的 for...of 去裸调 tools.execute(m.name, m.args),马上会遇到四个问题:
只读并发与写入串行 (executeToolCallBatch)
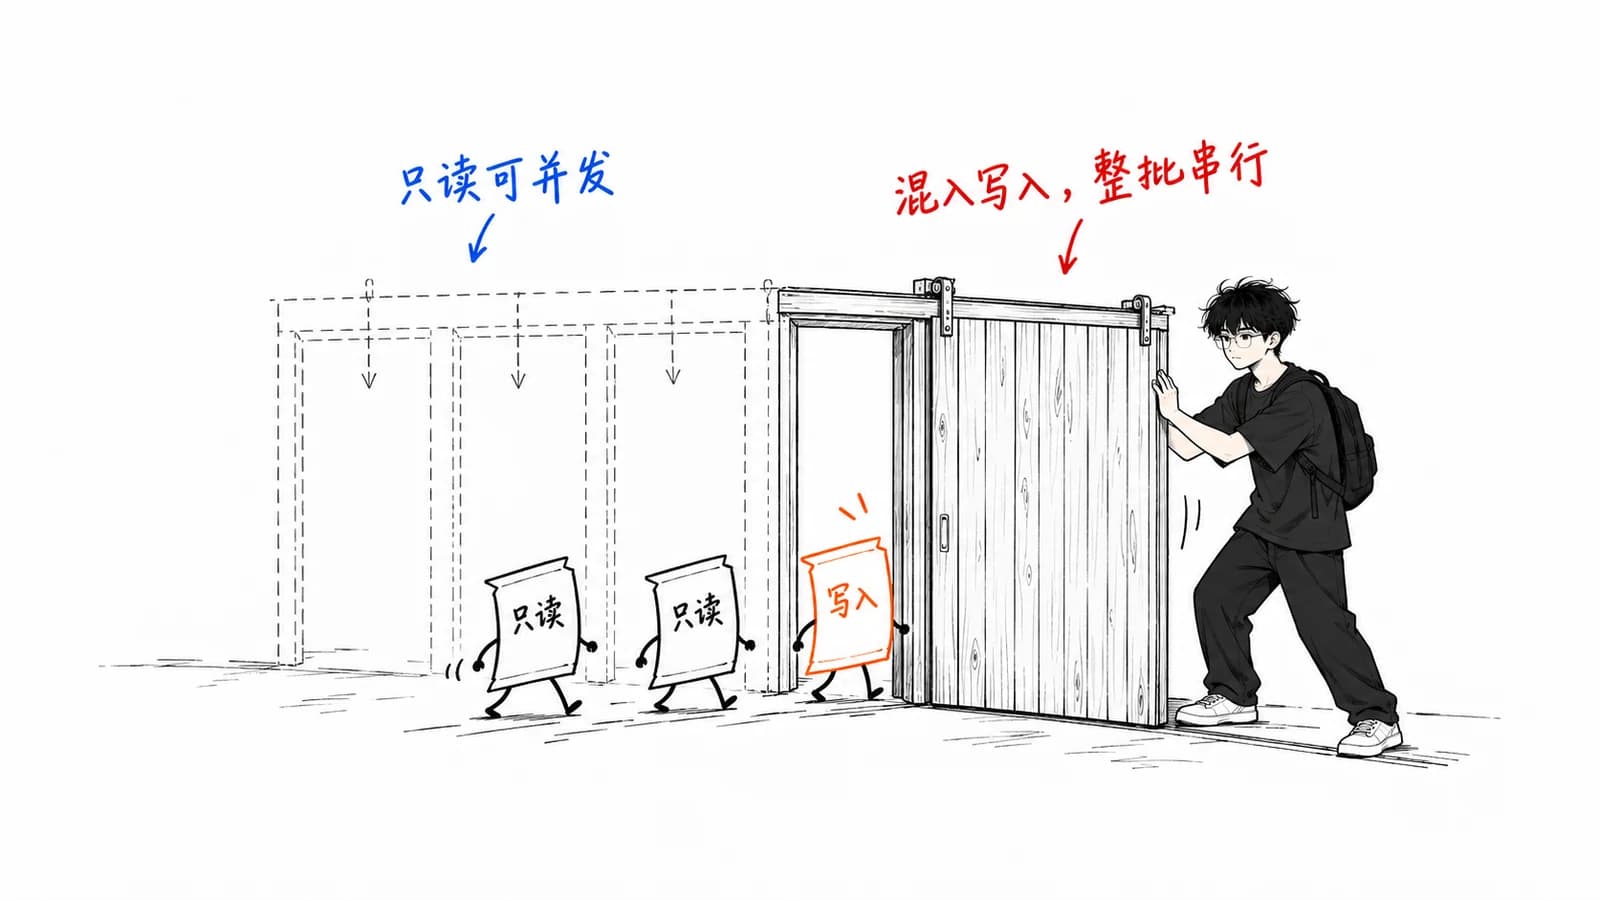
如果模型一次要读 5 个文件,用 for...of 串行读会白白浪费 I/O 等待时间;但反过来,如果模型同时返回了两个 Edit 工具调用去改同一个文件,或者一个 Edit 加一个 Bash 跑测试,全部并发跑就会引发文件读写冲突或竞态。
因此在 packages/agent/src/core/types.ts 中,每个工具都可以声明自己的执行模式 executionMode?: "sequential" | "parallel"。executeToolCallBatch 的调度逻辑如下:
async function executeToolCallBatch(run: AgentLoopRuntime, toolCalls: ToolCall[]): Promise<ExecutedToolBatch> {
  // ... 解析工具定义,检查批次内是否包含必须串行的工具
  const hasSequentialTool = resolvedToolCalls.some(({ tool }) => tool?.executionMode === "sequential");
  const sequential = config.toolExecution === "sequential" || hasSequentialTool;

  if (sequential) {
    for (const toolCall of resolvedToolCalls) {
      await publish(await executeToolCall(run, toolCall));
      if (signal?.aborted) break;
    }
  } else {
    // 全部是只读工具时并发执行,Promise.all 保持原请求顺序返回
    const outcomes = await Promise.all(resolvedToolCalls.map((tc) => executeToolCall(run, tc)));
    for (const outcome of outcomes) await publish(outcome);
  }
  // ...
}
规则很直接:只要这一批工具全部是只读工具(Read、Grep、Glob),就用 Promise.all 并发执行,并且利用 Promise.all 保持输入顺序的特性,按模型原本请求的顺序依次 publish 结果;一旦批次里混入任何一个标记为 "sequential" 的有副作用工具(Edit、Write、Bash),整批自动降级为 for...of 串行执行。
工具执行异常转 ToolResultMessage (isError: true)
模型并不是每次都能给出正确的工具调用。它可能会幻觉出一个不存在的工具名,可能会漏传必填参数(比如调 Edit 忘了传 new_string),或者要读取的文件路径根本不存在。
如果遇到这些错误直接 throw 异常退出 agentLoop,用户的任务动不动就断了。从实际体验来看,绝大多数这类错误只要把报错原因原样告诉模型,模型在下一轮自己就能改对。
所以在 executeToolCall 中,所有工具查找失败、参数 Schema 校验失败(validateToolArguments)以及工具内部抛出的异常都会被捕获,转化为一条带 isError: true 的 ToolResultMessage:
try {
  if (signal?.aborted) throw new ToolAborted({ message: "Tool execution aborted" });
  if (!tool) throw new ToolNotFound({ message: `Tool ${toolCall.name} not found` });

  const validation = validateToolArguments(tool, toolCall);
  if (validation.status === "error") {
    throw new ToolInvalidArguments({ message: validation.error.message });
  }
  // ... 执行工具 ...
} catch (error) {
  // 工具执行错误不能阻塞或炸断主循环,转为文本结果让模型在下一轮可见
  result = {
    content: [{ type: "text", text: error instanceof Error ? error.message : String(error) }],
  };
  isError = true;
}
模型在下一轮看到 role: "toolResult", isError: true 和具体的报错信息后,就能自己修正参数重新发起调用。
洋葱中间件与二次参数校验 (ToolMiddleware)
到了 Turn 2,模型要调用 Edit 修改 loop.ts,或者调用 Bash 执行命令。在真实的 Coding Agent(比如上层的 packages/coding-agent)里,一次工具调用在落地前后的横切逻辑非常多:外部插件(Extension)要在工具执行前改写参数、在执行后记录审计日志;权限系统(Permission)要先做 AST 静态扫描、弹窗等用户审批,审批通过后还要把工具放进受限的沙箱作用域里运行。
如果把这些逻辑硬编码在 agent-loop.ts 里,核心循环很快就会变成大泥球。但如果只提供一个简单的前置钩子 beforeToolCall(ctx),又管得了“进门”管不了“出门”。因此这里设计了洋葱模型的工具中间件 ToolMiddleware:
export type ToolMiddleware = (
  ctx: ToolCallContext,
  next: () => Promise<AgentToolResult>,
) => Promise<AgentToolResult>;
在 packages/coding-agent/src/runtime/assemble.ts 中,上层业务正是利用这个洋葱模型,由外向内套上了插件扩展层(extensionMiddleware)和权限沙箱层(permissionMiddleware):
[模型发出 ToolCall]
   │
   ▼  (第 1 次 validateToolArguments:防模型胡编参数弄崩插件)
┌──────────────────────────────────────────────────────────┐
│ 外层:extensionMiddleware (Extension 插件扩展层)           │
│   ├─ beforeToolCall:插件可拦截(block),或改写参数(args)   │
│   │                                                      │
│   ▼ ┌──────────────────────────────────────────────────┐ │
│     │ 内层:permissionMiddleware (权限审批与沙箱层)      │ │
│     │   ├─ 静态扫描 AST / 弹窗请求用户审批               │ │
│     │   ├─ 绑定 PathCapability / ExecutionPolicy 作用域 │ │
│     │   │                                              │ │
│     │   ▼  (第 2 次 finalArguments 校验:防插件改坏参数) │ │
│     │  [核心:tool.execute() 真正执行工具]               │ │
│     │   │                                              │ │
│     │   ▲  (退出沙箱作用域,临时授权自动失效)            │ │
│     └──────────────────────────────────────────────────┘ │
│   │                                                      │
│   ▲─ afterToolCall:无论成功或抛错,通知所有插件做审计/清理 │
└──────────────────────────────────────────────────────────┘
顺着这个洋葱图看,源码里的两个设计细节就非常清楚了:
- 为什么要用洋葱模型(
await next())?- 任意层随时短路:外层插件觉得违反策略,或者内层权限被用户点拒绝,直接
throw拒绝错误(不调next()),外面的agent-loop接住异常直接转成isError: true的ToolResultMessage,模型就能读到“调用被拒绝”的原因; - 包裹沙箱作用域:权限中间件审批通过后,并不是直接裸调
next(),而是调用withPathCapability(capability, next)把next()包在安全作用域里执行,等工具跑完退出作用域,临时文件授权自动回收; - 事后必达通知:外层的
extensionMiddleware用try { return await next() } finally / catch包住内层,确保不管工具执行成功还是报错,所有插件的afterToolCall钩子都能收到通知。
- 任意层随时短路:外层插件觉得违反策略,或者内层权限被用户点拒绝,直接
- 为什么要做两次参数校验(
validateToolArguments)?- 第 1 次校验(进洋葱前):防的是大模型乱传参数。先用工具定义的 Schema 校验一遍,免得把模型瞎编的脏参数传给插件和权限系统,导致插件代码报错。
- 第 2 次校验(穿出洋葱、进
tool.execute前):防的是中间的插件改坏参数。因为外层的 Extension 插件在beforeToolCall里可以合法地改写ctx.args(比如自动补全默认配置、替换路径)。万一某个第三方插件写出了 bug,把必填的path: string改成了undefined或数字,主循环在进入真实的tool.execute前用finalArguments再校验一次,就能当场拦截并报出明确的契约错误,不会让脏数据漏进底层文件操作。
多轮循环控制:插话、退出与消息规整
现在单轮的工具执行已经稳了,接下来看多轮循环的编排。
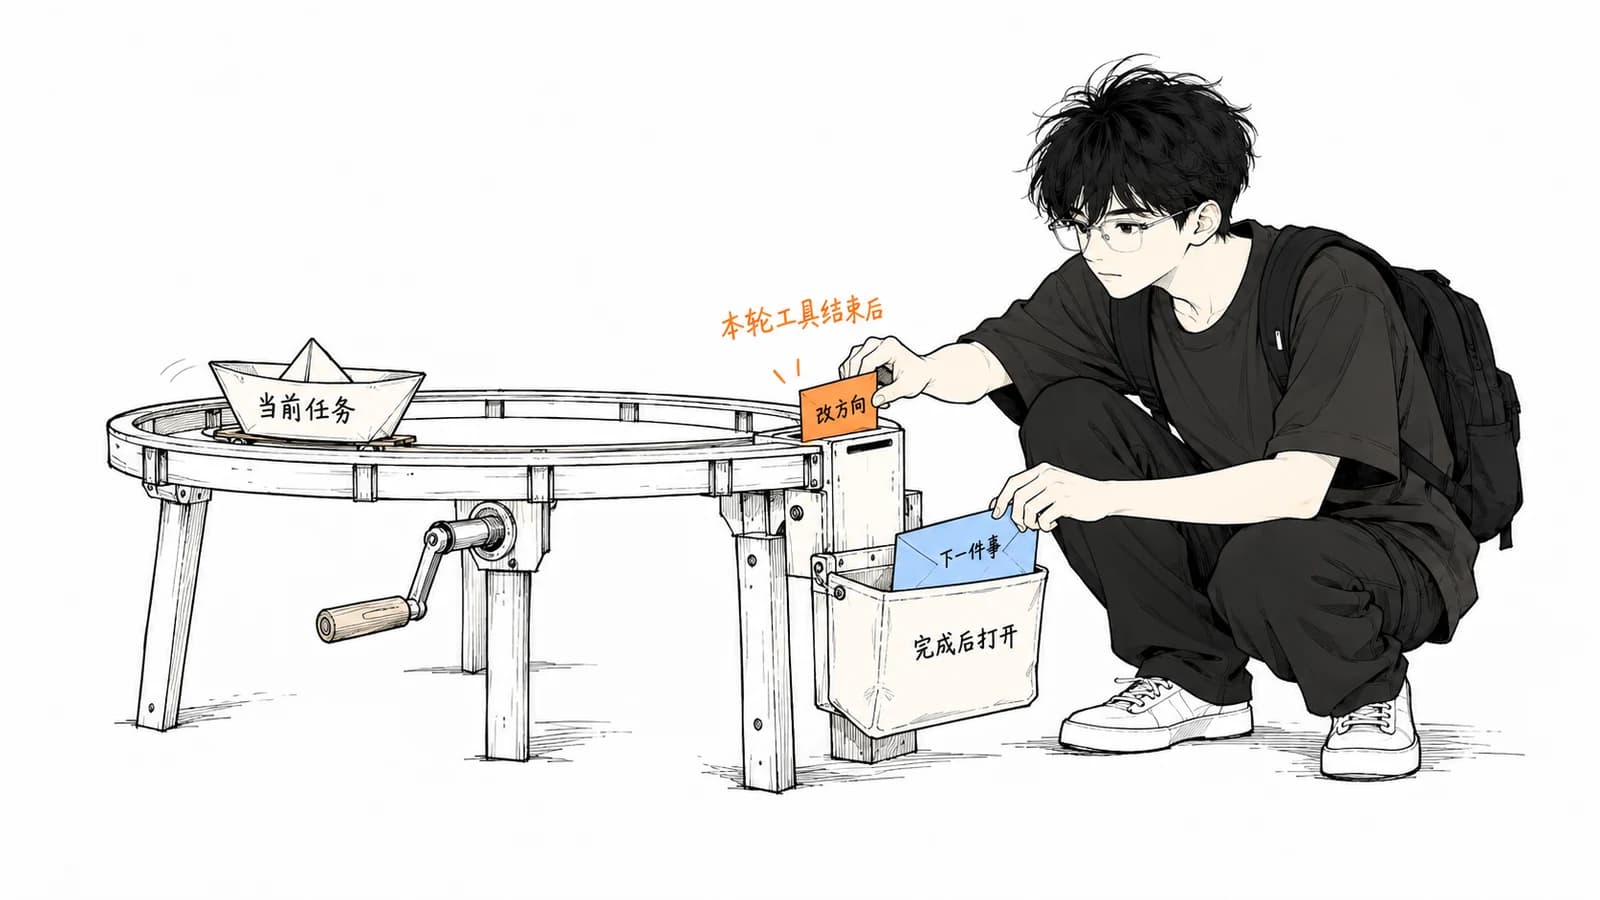
当 Agent 正在一轮接一轮地修 bug 时,用户不会只是干看着。用户在 Agent 运行期间敲回车发了一条新消息,在产品交互上存在两种完全不同的意图:
- 抢占式纠偏(Steering):Agent 正在改
loop.ts,用户发现它改错文件了,发了一句“停一下,别改loop.ts,去改index.ts”。这句话必须立刻插队,在当前这批工具跑完后、下一轮请求模型之前马上塞进上下文。 - 任务后追加(Follow-up):Agent 正在修 bug,用户顺手发了一句“修完这个之后,帮我把单元测试也跑一下”。这句话不应该打断当前的修 bug 流程,而是等当前任务彻底做完(模型不再调用工具)之后,再作为新任务接上去跑。
双层循环与退出条件 (driveAgentLoop)
为了同时支持这两种插话语义,还要防止模型陷入死循环,driveAgentLoop 采用了双层 while 循环结构:
while (true) {
  let hasMoreToolCalls = true;

  // 内层循环:推进当前任务,直到模型不再调工具且没有 steering 抢占消息
  while (hasMoreToolCalls || pendingMessages.length > 0) {
    if (config.maxIterations !== undefined && turnCount >= config.maxIterations) {
      // 1. 轮次超限保护:追加 iterationLimit 提示消息并退出 ...
      return;
    }

    const turn = await runTurn(run, pendingMessages);
    turnCount += 1;

    if (turn.stopped || signal?.aborted) {
      // 2. 收到 error / aborted / contextOverflow 立即收尾退出 ...
      return;
    }

    hasMoreToolCalls = turn.hasMoreToolCalls;
    // 3. 每个 Turn 结束后拉取 Steering 抢占消息,在下一轮模型请求前注入
    pendingMessages = (await config.getSteeringMessages?.()) ?? [];
  }

  // 外层循环:当前任务自然结束后,检查是否有排队的 Follow-up 消息开启新任务
  const followUpMessages = (await config.getFollowUpMessages?.()) ?? [];
  if (followUpMessages.length > 0) {
    pendingMessages = followUpMessages;
    continue;
  }
  break;
}
可以看到,主循环会在四个明确的边界停下来:
- 自然结束:内层循环
hasMoreToolCalls为false,且没有 Steering 和 Follow-up 消息。 - 轮次超限(
maxIterations):当turnCount达到预设上限时,主动构造一条stopReason: "iterationLimit"的消息追加到结尾并退出。 - 用户主动取消(
aborted)或模型报错(error):runTurn检测到message.stopReason为"error"或"aborted"时,不再执行该消息里的工具调用,直接标记turn.stopped = true退出。 - 上下文窗口超限(
contextOverflow):模型输出因为达到最大上下文限制被截断时,里面的工具调用往往是半截残缺的。此时runTurn同样不会去执行那些半截工具,而是保留消息并标记stopped: true退出,交给上层先做完上下文压缩(Compaction)再继续。
消息配对规整与空消息过滤 (projectToolCallProtocol)
在经历了中途报错、用户取消或者 prepareContext 裁剪之后,历史消息数组里很容易留下两类会让大模型接口直接报 400 Bad Request 的脏数据:
- 报错或秒取消留下的“空壳
assistant消息”(content: []): 当某次模型请求刚发出就遇到网络报错(stopReason: "error"),或者模型一个字还没吐出来用户就按下了ESC取消(stopReason: "aborted"),主循环依然会往历史里记录一条role: "assistant", content: []的消息(方便 UI 展示“上一轮已取消/报错”)。但当用户接着发起下一轮对话时,Anthropic 等接口严禁消息列表里出现content为空数组的记录,一旦原样发过去就会收到400: messages.1.content must not be empty。 - 上下文裁剪产生的“孤儿
toolResult”与配对错位: OpenAI 和 Anthropic 都有一条死规矩:每条toolResult必须紧跟在发起该调用的assistant(toolCall)消息正后方。如果业务层或插件在prepareContext里做滑动窗口截断(比如简单粗暴地写了个messages.slice(-10)),刚好把前面的assistant(toolCall)切掉了,只留下后面的toolResult(成了找不到爹的“孤儿结果”);或者插件往这两条消息中间插了一条系统提醒,直接发给模型就会立刻报400: tool_result must follow an assistant message with a matching tool_use。
为了在发请求前把这两类脏数据彻底洗干净,每次调用模型前都会过一道纯函数 projectToolCallProtocol(位于 packages/agent/src/core/tool-protocol.ts):
export function projectToolCallProtocol(messages: readonly AgentMessage[]): AgentMessage[] {
  const results = new Map(/* 先按 toolCallId 建立所有 toolResult 的索引 ... */);
  const projected: AgentMessage[] = [];

  for (const message of messages) {
    if (message.role === "toolResult") continue; // 1. 先跳过所有单飞的 toolResult(自动丢弃孤儿结果)
    if (message.role === "assistant" && message.content.length === 0) continue; // 2. 过滤报错/取消留下的空壳消息
    projected.push(message);
    if (message.role !== "assistant") continue;
    // 3. 只有当 assistant 消息存在时,才按它的 toolCall 顺序把对应的 toolResult 紧贴着排在后面
    for (const part of message.content) {
      if (part.type === "toolCall" && results.has(part.id)) {
        projected.push(results.get(part.id)!);
      }
    }
  }
  return projected;
}
经过这十几行代码的规整,空壳消息被剔除,孤儿 toolResult 被自动丢弃,配对的 toolResult 被强制拉回到所属 assistant 消息的正后方,发往网络的消息序列永远符合各家协议的校验要求。
异常处理:流式消息撤回与超时取消
把前面几部分拼起来,一个功能完整的 Agent Loop 就已经成型了。在实际跑编码任务时,还有两个边界情况需要单独处理。
协议违规时的流式消息撤回 (message_discard)
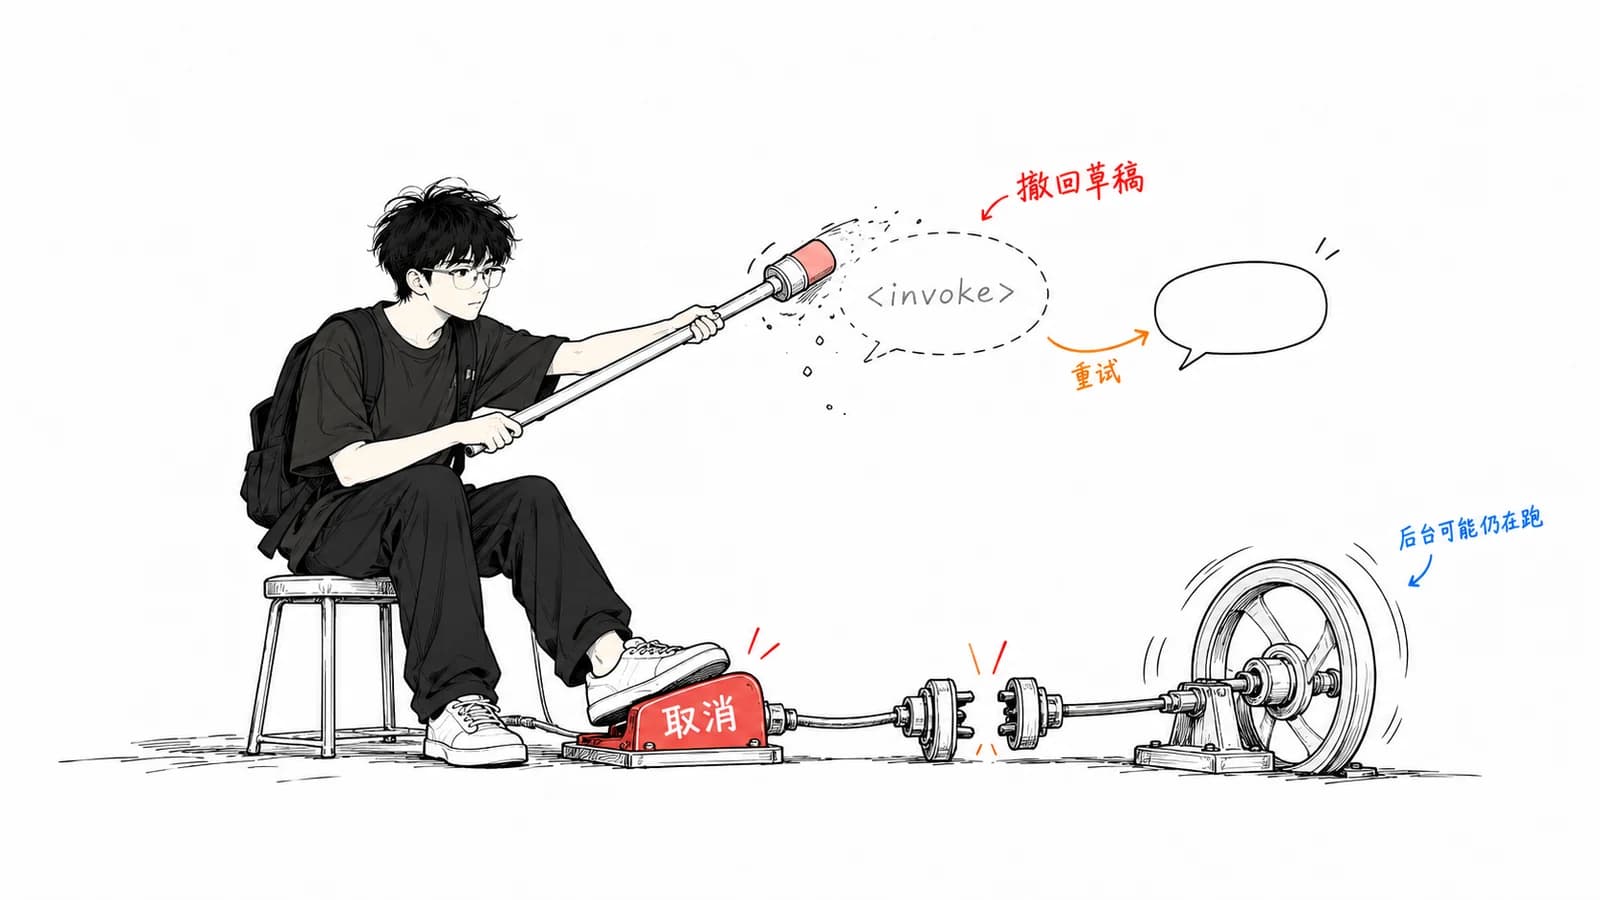
在上一章末尾我们讲过,有些模型受微调数据影响,没有触发原生的 Function Calling,而是在普通文本里直接手写 <invoke name="Read">...</invoke> 这样的 XML 标签。packages/ai 会在流结束时识别出这种假调用,并在消息上打上 ModelOutputProtocolViolation 标记。
到了 agentLoop 这一层,我们希望给模型一次自动纠错的机会:发现它吐了 XML 假调用,就偷偷塞一条提示词让它改用原生工具协议重发一次。
但这里有一个流式时序矛盾:主循环是边接收流,边向前端广播 message_update 事件的。等到流结束、packages/ai 判定出协议违规时,前端界面上已经把那段带 <invoke> 标签的脏文字实时渲染给用户看了。如果这时候直接发起重试,用户界面上就会先留下一段莫名其妙的 XML 代码,紧接着又跳出一段新回复。
为了解决这个时序矛盾,streamAssistantResponse 引入了带**撤回语义(message_discard)**的重试机制:
let attempt = await attemptModelCall(run, attemptContext);

if (isModelOutputProtocolViolation(attempt.message)) {
  // 1. 如果刚才那次尝试已经向外部发过 message_start,立刻发一条 message_discard 通知前端撤回气泡
  if (attempt.started) {
    await run.emit({ type: "message_discard" });
  }
  // 2. 在临时上下文里追加一条不落盘的纠正提示,要求模型改用原生工具协议重来一次
  const directive = config.onModelError ? await config.onModelError(attempt.message, prepared) : undefined;
  attemptContext = appendProtocolRepairMessage(directive?.context ?? prepared);
  attempt = await attemptModelCall(run, attemptContext);
}
前端 UI 收到 message_discard 事件后,会直接把刚刚渲染到一半的草稿消息抹掉;而那条用来提醒模型的纠正提示只存在于临时的 attemptContext 中,不会 push 到 runtime.context.messages 里。如果重试成功,用户看到的就是一次平滑的正常调用,会话历史里也不会留下任何协议报错的痕迹。
工具取消竞态保护 (raceAbort)
当用户觉得 Agent 跑太久、按下 ESC 触发 AbortSignal 时,理想情况下所有正在执行的工具都应该立刻退出。
但在实际接入外部工具(比如自定义的 MCP 工具、网络请求或某些耗时脚本)时,很多工具实现根本没有监听传入的 signal 参数。如果主循环老老实实地 await tool.execute(...),只要有一个工具无视了取消信号,整个 agentLoop 就会被它永久挂起,用户点了取消界面却依然卡在运行中。
为了防止主循环被不守规矩的工具绑架,executeToolCall 在最外层用 raceAbort 包了一道竞态保护:
function raceAbort<T>(work: Promise<T>, signal: AbortSignal | undefined): Promise<T> {
  if (!signal) return work;
  return new Promise<T>((resolve, reject) => {
    const onAbort = () => reject(new ToolAborted({ message: "Tool execution aborted" }));
    signal.addEventListener("abort", onAbort, { once: true });
    work.then(resolve, reject).finally(() => signal.removeEventListener("abort", onAbort));
    if (signal.aborted) onAbort();
  });
}
只要外部的 signal 一触发,raceAbort 不管底层的 work 有没有结束,立刻 reject 抛出 ToolAborted,让主循环马上推进到 agent_end 释放控制权。(至于那个还在后台跑的操作系统子进程怎么彻底杀干净,我们会在后续执行环境章节的进程组 Kill Boundary 中单独解决。)
小结
从最初 15 行的 while (true) 走到完整的 packages/agent/src/core/agent-loop.ts,我们做的每一处改动都对应着一个具体的生产问题:
- 为了打破黑盒并保护调用方状态,拆出了 Run / Turn / Message 三层事件流与
AgentLoopRuntime副本隔离; - 为了兼顾工具执行速度与安全,设计了只读并发、写操作串行的批次调度,用洋葱中间件挂载插件扩展与权限沙箱,并把工具异常转为
isError: true的消息让模型自愈; - 为了支持运行中交互,用内外双层循环区分了抢占式插话(Steering)与排队任务(Follow-up),并用
projectToolCallProtocol清洗了空壳消息与孤儿工具结果; - 最后用
message_discard和raceAbort兜住了流式脏输出回滚与慢工具取消卡死。
除此之外,源码里其实还埋了一组 EffectBoundary 钩子:如果 Agent 刚把 Edit 工具派发出去、文件改了一半,宿主进程突然断电崩溃了,重启之后怎么知道这个工具到底跑没跑完?这个问题会在后续讲持久化 Journal 与崩溃恢复时专门拆解。
而在那之前,随着主循环跑的轮次越来越多,context.messages 会迅速膨胀。一旦对话历史逼近模型的上下文窗口上限,或者动态拼接的内容破坏了前缀稳定性,推理成本和延迟就会急剧恶化。下一章,我们先来解决上下文管理、KV Cache 断点保护与后台投机压缩(Compaction)。
下一章:上下文管理、KV Cache 断点与 Compaction(待发布)。